摘要:本文基于一套可复用的 YOLO11 训练包,完整介绍如何在 GPU 服务器上训练单类别「抛洒物(spill)」检测模型:从环境搭建、目录约定、数据格式、单卡/多卡训练,到验证指标解读与结果复盘;并总结换其他检测任务时的通用打法。
适合读者:具备基础 Linux / Python 能力,希望快速把目标检测落到业务场景的工程师。
技术栈:Ultralytics YOLO11 · PyTorch · CUDA · 可选多卡 DDP
目录
1. 业务问题与技术选型
道路、隧道、城市道路监控里,「抛洒物」是一类高频风险:纸箱、编织袋、轮胎碎片、施工遗留物等,可能引发追尾或二次事故。业务侧通常需要:
有没有抛洒物(检出)
在哪里(定位框)
能不能稳定上线(可训练、可复现、可交付)
从算法看,这就是标准的 单类别目标检测:一张图里找出所有 spill 目标。
我们没有从零造检测器,而是选择 Ultralytics YOLO11:
整条链路可以概括为:
标注数据 → spill_data.yaml → YOLO11 预训练权重
        → train_yolo11_spill_gpu.sh(单卡/多卡)
        → best.pt → 业务推理 / 部署
2. 仓库地图:一眼看懂每个目录
先建立「空间感」。建议把仓库理解成四块:原料、底模、生产线、成品。
spill_yolo11_gpu_training/
│
├── datasets/                         【原料】模型吃什么
│   ├── spill_data.yaml               ← 数据说明书:路径 / 类数 / 类名
│   ├── train/{images,labels}/        ← 训练图 + 同名 YOLO 标签
│   └── valid/{images,labels}/        ← 验证图 + 标签(选 best、早停靠它)
│
├── models/
│   ├── pretrained/yolo11n.pt         【底模】COCO 预训练起点
│   └── trained/                      【成品】训完后的交付权重与 CSV
│       ├── yolo11n_spill_1k_best.pt
│       └── yolo11n_spill_1k_results.csv
│
├── scripts/                          【生产线】怎么训
│   ├── train_yolo11_spill.py         ← Python:参数 → Ultralytics
│   └── train_yolo11_spill_gpu.sh     ← Shell:环境变量 → 调 Python
│
├── results/charts/                   【复盘】曲线图
│   └── yolo11n_spill_1k_curves.png
│
├── docs/                             【说明】运维细则与本文
├── requirements-gpu.txt              【依赖】ultralytics 等(不含 PyTorch)
├── README.md / README-CN.md
└── runs/                             【实验产物】训练时自动生成
目录用途对照表
记忆口诀:数据在 datasets,起点在 pretrained,命令在 scripts,交付在 trained。
3. 环境搭建:从驱动到 ultralytics
检测训练的「环境坑」往往比算法更耗时。按下面顺序确认即可。
3.1 确认 GPU 驱动
nvidia-smi能看到 GPU 名称、驱动版本、显存,就说明驱动层正常。同时记下可见卡数,后面多卡要用。
3.2 创建独立 conda 环境
conda create -n spill-yolo11 python=3.11 -y
conda activate spill-yolo11
不要用系统自带 Python 硬装依赖,避免权限与版本污染。
3.3 安装带 CUDA 的 PyTorch
仓库里的 requirements-gpu.txt 不包含 PyTorch,需按 CUDA 版本单独安装。本训练包验证过的组合接近 torch 2.x + cu128:
python -m pip install --upgrade pip
python -m pip install torch torchvision --index-url https://download.pytorch.org/whl/cu128
若驱动较旧,请到 PyTorch 官网 选择匹配的 CUDA 版本。
3.4 安装训练依赖
在仓库根目录:
python -m pip install -r requirements-gpu.txt会安装 ultralytics、opencv-python-headless、pyyaml、pandas、tqdm 等。
3.5 环境自检(必做)
python - <<'PY'
import torch, ultralytics
print("torch:", torch.__version__)
print("cuda:", torch.version.cuda)
print("available:", torch.cuda.is_available())
print("gpu count:", torch.cuda.device_count())
print("ultralytics:", ultralytics.__version__)
if torch.cuda.is_available():
    print("gpu0:", torch.cuda.get_device_name(0))
PY通过标准:available: True,且 gpu count >= 1。
若 CUDA 不可用,先不要开训——优先排查驱动与 PyTorch CUDA 版本是否匹配。
4. 数据约定:yaml、标签与检查清单
4.1 数据说明书 spill_data.yaml
train: train/images
val: valid/images

nc: 1
names:
  0: spill
三件事说清楚:
训练图在哪、验证图在哪
一共几类(
nc: 1)每类叫什么(
0 → spill)
路径相对 datasets/ 目录解析。
4.2 YOLO 标签格式
每张 xxx.jpg 对应 xxx.txt,每行一个框:
0 0.512 0.448 0.091 0.0564.3 开训前检查清单
train/images与train/labels基本一一对应valid/非空(否则难以选出可信best.pt)所有标签类别 ID 仅为
0在仓库根目录执行脚本,而不是在
scripts/里套路径
5. 开始训练:单卡、多卡与常见卡点
5.1 单卡(默认)
conda activate spill-yolo11
cd /path/to/spill_yolo11_gpu_training

bash scripts/train_yolo11_spill_gpu.sh
默认大致为:
5.2 多卡(以 8 卡为例)
DEVICE=0,1,2,3,4,5,6,7 \
BATCH=128 \
NAME=yolo11n_spill_8gpu \
bash scripts/train_yolo11_spill_gpu.sh
说明:
DEVICE为本地可见卡号列表,Ultralytics 走 DDPBATCH建议随卡数近似放大(单卡 16 → 8 卡约 128)换独立
NAME,避免覆盖旧实验目录
限定物理卡再训练:
CUDA_VISIBLE_DEVICES=4,5 DEVICE=0,1 BATCH=32 \
NAME=yolo11n_spill_gpu45_2gpu \
bash scripts/train_yolo11_spill_gpu.sh
物理 4、5 会被映射成进程内 0、1,因此 DEVICE 只能写 0,1。
5.3 日志读到哪一步算「正式开训」
初始化阶段常见:
Overriding model.yaml nc=80 with nc=1
Transferred ... items from pretrained weights
AMP: running Automatic Mixed Precision (AMP) checks...
含义:检测头已从 COCO 80 类改为 1 类,预训练权重已迁移,正在做混合精度检查。
真正进入训练要看到类似:
Starting training for 150 epochs...
1/150 ...
5.4 AMP 卡在下载?
若停在下载 yolo26n.pt,那是 AMP 自检临时拉小模型,不是任务模型被替换。外网差时:
AMP=False DEVICE=0,1,2,3,4,5,6,7 BATCH=128 \
bash scripts/train_yolo11_spill_gpu.sh
6. 训练结果(1k 实验)与指标解释
本节展示本项目在约 1k 量级、类别干净(仅 class 0) 数据上的一次完整实验结果。对应权重与曲线:
权重:
models/trained/yolo11n_spill_1k_best.pt日志:
models/trained/yolo11n_spill_1k_results.csv曲线:
results/charts/yolo11n_spill_1k_curves.png
6.1 结果总表
6.2 训练过程关键节点
可以看到:前 20 个 epoch 指标爬升最快,之后是「变稳、变准」的细磨阶段。本次实验中 best 与 last 同为第 150 轮,说明训练结束时验证集仍在受益,没有明显后期崩盘。
6.3 训练曲线
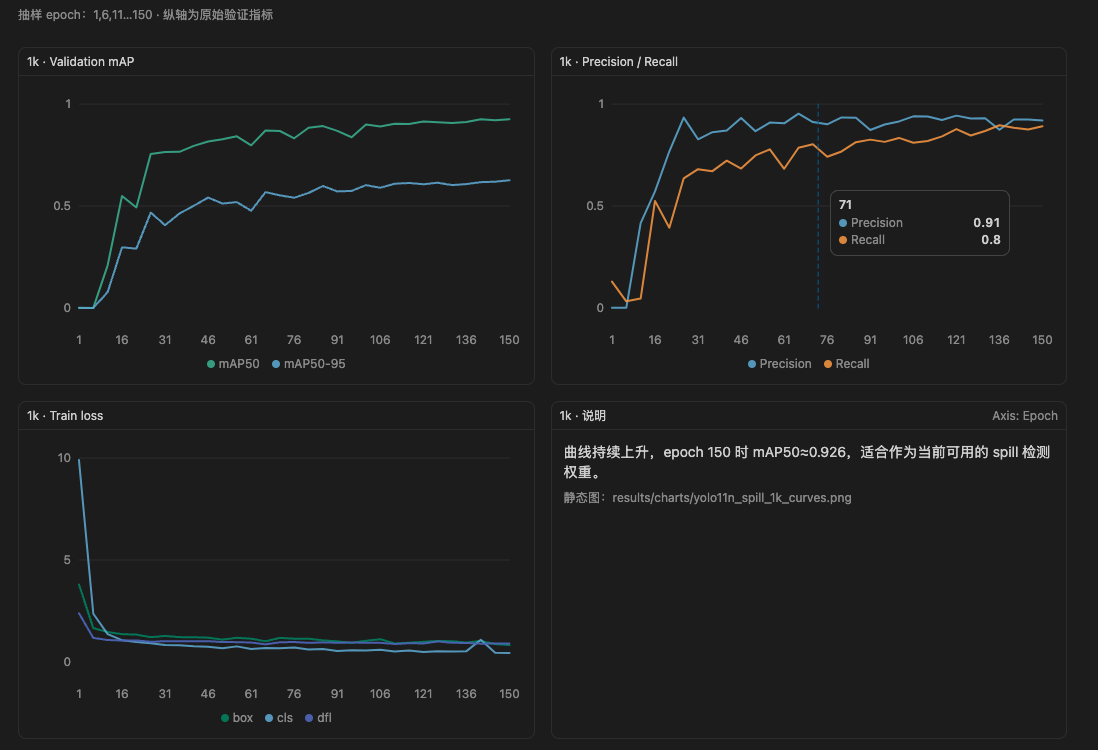
图中通常包含四块:
Validation mAP:看模型「越训越好不好」
Precision / Recall:看「检得准不准、漏不漏」
Train loss:看优化是否在收敛
Val loss:辅助判断是否过拟合
6.4 指标解释(对外评审最常问)
先记住一张关系图:
模型预测框 ──IoU──► 与真值框是否算「配对成功」
        │
        ├─ 算进 TP / FP ──► Precision / Recall
        └─ 在不同 IoU 阈值下平均 ──► mAP50 / mAP50-95
IoU(交并比)是什么?
预测框与标注框的重叠程度:
\mathrm{IoU} = \frac{面积_{交集}}{面积_{并集}}
IoU 越高,框得越准。检测里常用阈值(如 0.50)判断「这个预测算不算检对了」。
Precision(精确率)
\mathrm{Precision} = \frac{TP}{TP + FP}
高:报出来的框里,误报少(「说有抛洒物时更可信」)
低:容易「草木皆兵」,把正常路面也框成抛洒物
本次 0.920:平均而言,模型给出的阳性结果里约九成靠谱。
Recall(召回率)
\mathrm{Recall} = \frac{TP}{TP + FN}
高:真抛洒物漏得少
低:漏检多,安全场景里往往更危险
本次 0.892:大部分真实目标能被找回。业务若更怕漏检,可在推理时适当降低 conf 阈值换更高召回(同时可能增加误报)。
mAP50
在 IoU = 0.50 阈值下的平均精度(Average Precision)。
相对宽松:框得大致对就算检中。适合作为「模型有没有学会这个类」的第一眼指标。
本次 0.926:在 0.5 IoU 标准下表现很强。
mAP50-95
在 IoU 从 0.50 到 0.95、步长 0.05 多个阈值上的平均 mAP。
更严格:不仅要「找得到」,还要「框得准」。工业界常把它看作比 mAP50 更「硬核」的定位质量指标。
本次 0.626:低于 mAP50 是正常现象——阈值变严后分数一定会掉。若业务强依赖精确落框(例如联动测距/告警区域),应更关注 mAP50-95,并考虑加大 IMGSZ 或换更大模型继续抠定位。
和 Loss 的关系
Loss 下降 ≠ 业务可用;最终仍以验证集 mAP / P / R 为准。
反过来:若 train loss 一直降、val mAP 却长期接近 0,优先怀疑 验证集标注/类别与 yaml 不一致,而不是盲目加大模型。
6.5 如何理解这组数(业务语言)
一句话给产品/业务同学:
在当前 1k 规模、标注干净的验证集上,模型大约能找回 89% 的抛洒物,报出的结果里约 92% 是对的;在「框得比较准」的宽松标准(IoU=0.5)下综合表现约 0.93,在更严格的定位标准下约 0.63。
上线前仍建议:用真实摄像头回流数据做一次业务抽检,并按场景调 conf / iou 阈值。
7. 权重怎么选、怎么推理
7.1 best.pt vs last.pt
本次 1k 实验中两者同为第 150 轮,但习惯上对外仍发布 best.pt 命名的交付件。
7.2 归档建议
mkdir -p models/trained
cp runs/spill_yolo11/<NAME>/weights/best.pt \
   models/trained/yolo11n_spill_1k_best.pt
7.3 最小推理代码
from ultralytics import YOLO

model = YOLO("models/trained/yolo11n_spill_1k_best.pt")
results = model.predict(
    "path/to/image.jpg",
    imgsz=960,   # 尽量与训练接近
    conf=0.25,   # 阈值可按业务调
)
results[0].show()
# results[0].save()  # 如需落盘可视化结果
8. 换任务的通用方法论
抛洒物只是「单类/少类检测」的一个实例。换成安全帽、烟火、行人、裂纹,流水线几乎不变,变的是数据与命名。
8.1 永远不变的五步
1. 准备 YOLO 格式数据(images + labels)
2. 编写 data.yaml(路径 + nc + names)
3. 选择预训练权重(yolo11n / s / m ...)
4. 启动训练(单卡或 DEVICE=0,1,...)
5. 使用 best.pt 做验证与业务接入
8.2 一定要改的
三类别示例:
train: train/images
val: valid/images

nc: 3
names:
  0: helmet
  1: no_helmet
  2: person
8.3 常常要拧的旋钮
8.4 推荐的「换皮」顺序
保持目录结构,只换数据内容
新建 yaml,不覆盖旧任务配置
人工抽查 20 张:框准不准、ID 对不对
小规模短训,确认链路与指标方向
全量训练,独立
NAME按规范归档:
yolo11n_<task>_best.pt
即使不改脚本文件名,也可以纯靠环境变量切换任务:
DATA=datasets/helmet_data.yaml \
PROJECT=runs/helmet_yolo11 \
NAME=yolo11n_helmet_8gpu \
DEVICE=0,1,2,3,4,5,6,7 \
BATCH=128 \
bash scripts/train_yolo11_spill_gpu.sh脚本叫什么不重要,DATA 和数据内容才决定任务。
9. 排错速查与交付清单
9.1 排错速查
9.2 对外交付清单
开训前
nvidia-smi正常import torch, ultralytics成功且 CUDA 可用yaml 与标签类别一致
train/valid 非空、类别干净
交付时
发布
best.pt记录:
NAME、MODEL、IMGSZ、数据版本、关键指标附上
results.csv与曲线图业务侧确认推理
imgsz/conf与训练同量级,并做实景抽检
10. 结语
抛洒物检测并不需要神秘配方。把它拆开,就是:
干净的单类 YOLO 数据 + 一份 yaml + YOLO11 预训练权重 + 可配置的 GPU 训练入口。
本训练包已经帮你收好了目录约定、默认超参、单卡/多卡启动方式。你只要:
看懂
datasets/models/scripts各自负责什么;把环境验到 CUDA 可用;
跑通训练,拿走
best.pt;换任务时优先换数据与 yaml,用环境变量切换实验名。
在约 1k、标注干净的实验中,模型达到 mAP50 ≈ 0.926、mAP50-95 ≈ 0.626、Precision ≈ 0.920、Recall ≈ 0.892,说明这条流水线足以支撑垂直场景的第一版可用模型;后续优化重点通常在 更多真实回流数据、更干净的验证集、以及按业务权衡召回与误报。
本文为对外技术分享整理,基于 YOLO11 Spill Detection 训练包的真实 1k 实验与工程实践。